ZCBUS增量发布使用 PostgreSQL 物理复制槽说明
一、 核心背景与原因
在常规的 PostgreSQL 逻辑同步中,CDC 工具通常会创建“逻辑复制槽”。但 ZCBUS 官方文档明确要求并仅支持创建“物理复制槽”(Physical Replication Slot)。
这是因为 ZCBUS 为了兼容多种 PostgreSQL 版本(包括 PG 10 以前不支持逻辑槽的老版本),底层采用了物理槽机制来“占位”保护日志,而具体的数据解析和捕获,由 ZCBUS 自身内部引擎直接读取 WAL 文件来完成。
二、 物理复制槽的真正作用
在 ZCBUS 的架构中,物理槽不负责记录业务消费进度,它的核心作用只有一个:
- 防止 WAL 日志被误删(安全护栏):主库会“记住”当前槽位的最低安全水位(
restart_lsn)。只要槽位存在,主库就绝对不会清理该位置之后的 WAL 文件,防止 ZCBUS 还没读取的日志被数据库自动清理导致数据断层。ZCBUS 会在后台通过底层协议定期推进这个水位线。
(注:ZCBUS 的精确消费进度是由其业务表 bus_push_capture 记录的,而非依赖数据库槽位。)
三、 运行原理:ZCBUS 到底是如何工作的?
根据 ZCBUS 的实际运行日志,它的底层工作流分为以下三步:
- 自主定位 WAL 文件:ZCBUS 在内部维护了精确的读取位置(即“WAL 文件名 + 字节偏移量”,如
0000000100000000000000FA, 61112),直接去读取对应的 WAL 文件。 - 独立业务表记录进度(核心追踪机制):当 ZCBUS 解析完数据并成功发送到下游缓存后,它会执行普通的 SQL 语句,将最新进度更新到自己的业务表中(如
update bus_push_capture set position=...)。程序重启或断点续传都完全依赖这张表。 - 物理槽“防误删”:ZCBUS 通过 PostgreSQL 专用的流复制协议(底层二进制包,不经 SQL 解析器)定期向主库发送状态更新,促使主库推进物理槽的
restart_lsn,确保自己下一步要读的 WAL 文件还在。
四、 如何查看与验证槽位状态?
主要使用 pg_replication_slots 视图进行查询。
1. 查看槽位基本信息与健康度
SELECT slot_name, slot_type, active, restart_lsn,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained_wal
FROM pg_replication_slots
WHERE slot_name = 'zcbus_slot';active:必须为t(True),表示 ZCBUS 正常连接。retained_wal:表示积压的 WAL 大小。正常情况下应极小(如 16 kB)或稳定在一个低水位。如果持续暴涨,说明 ZCBUS 卡住了或未向数据库反馈。restart_lsn:当前数据库保留的最低水位(物理槽的confirmed_flush_lsn字段永远为空,属正常现象)。
2. 查找是谁在连接这个槽位
SELECT s.slot_name, s.active_pid, r.client_addr, r.state, r.backend_start
FROM pg_replication_slots s
LEFT JOIN pg_stat_replication r ON s.active_pid = r.pid
WHERE s.slot_name = 'zcbus_slot';client_addr:显示 ZCBUS 所在机器的 IP。state:显示为streaming说明数据正在正常流式传输。
五、 如何排查槽位是否在正常推进?
排查物理槽是否在推进,分为“验证数据库层防删除水位线是否在动”和“验证 ZCBUS 业务层数据是否在正常抓取”两个维度。
1. 验证数据库层:截图验证法(强制切换 WAL)
这是最直观的验证方法。通过强制 PostgreSQL 切换 WAL 文件,观察物理槽的 restart_lsn 是否随之推进。
操作步骤:
执行切换日志:
select pg_switch_wal();第一次查询槽位位置:
SELECT slot_name, active, restart_lsn
FROM pg_replication_slots
WHERE slot_name = 'zcbus_slot';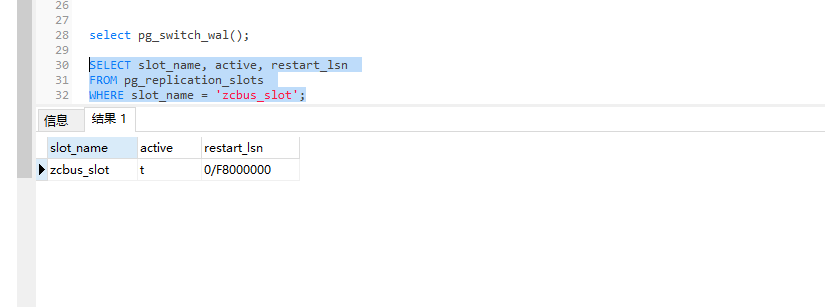
(截图结果:restart_lsn 为 0/F8000000)等待几十秒(让 ZCBUS 消费完新切换的 WAL 文件并向数据库发送反馈包)。
第二次查询槽位位置:
执行同样的查询语句。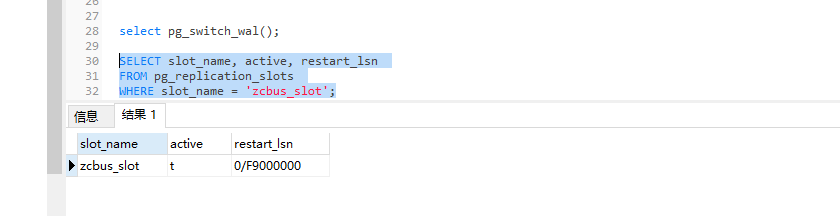
(截图结果:restart_lsn 推进到了 0/F9000000)
结论:LSN 从 F8000000 推进到了 F9000000,证明 ZCBUS 正在完美且实时地向主库反馈进度,物理槽防误删的保护水位线在正常推进。
2. 验证业务层:查看 ZCBUS 内部进度表(最准确)
虽然数据库层的物理槽在推进,但 ZCBUS 实际抓取到了哪里,是由它自己的元数据表决定的。直接查询 ZCBUS 的进度表:
SELECT nodeid, delay, position FROM bus_push_capture WHERE nodeid=13607;- 判断标准:隔几分钟执行一次,如果
position(如0000000100000000000000FA, 61296)的偏移量在不断变大,且delay保持在合理范围内,说明 ZCBUS 内部消费完全正常。
3. 验证健康度:查看 WAL 积压量(防爆盘)
如果 ZCBUS 卡住不推进,数据库会持续积压 WAL 导致磁盘撑爆。执行以下 SQL 查看积压量:
SELECT slot_name, active,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained_wal
FROM pg_replication_slots
WHERE slot_name = 'zcbus_slot';- 健康状态:
retained_wal维持在较小的稳定值(如你之前查到的16 kB左右)。 - 异常状态:
retained_wal呈指数级持续暴涨,说明 ZCBUS 进程死掉、网络断开,或者被数据库的长事务“钉住”了。
4. 排查隐藏杀手:长事务“钉住”槽位
即使 ZCBUS 正常,如果数据库中存在未提交的长事务,也会导致 restart_lsn 卡住不动。排查 SQL:
SELECT pid, state, age(backend_xid) AS xid_age,
       now() - xact_start AS xact_age, left(query, 60) AS query
FROM pg_stat_activity
WHERE backend_xid IS NOT NULL
ORDER BY age(backend_xid) DESC;
如果发现执行时间极长的 idle in transaction 或长事务,需联系业务方处理,否则 WAL 将无法被回收。
六、 常见处理与避坑指南
- 只有一个主节点,没有备库,槽位怎么办?
只要 ZCBUS 在连接(active=t),就绝对不能删。ZCBUS 就是它的消费者。 - 能不能用
pg_replication_slot_advance()手动推进?
强烈禁止。 ZCBUS 内部用bus_push_capture追踪进度。如果你手动推进了数据库侧的restart_lsn,数据库会清理 WAL,但 ZCBUS 下次启动仍按自己的进度表去读旧文件,会导致找不到 WAL 文件而报错,甚至数据永久丢失。 - 什么时候可以删除槽位?
如果决定不再使用 ZCBUS 同步该库,且active变为f(False)时,可执行SELECT pg_drop_replication_slot('zcbus_slot');。如果处于t状态想强删,需先pg_terminate_backend(active_pid)杀掉连接,再执行 drop(注意:强删后 ZCBUS 需重新做全量初始化)。